
Xiaomi представила открытую ИИ-модель CocktailASR-1, решающую задачу распознавания голоса конкретного человека среди множества говорящих одновременно людей — так называемый «эффект коктейльной вечеринки».
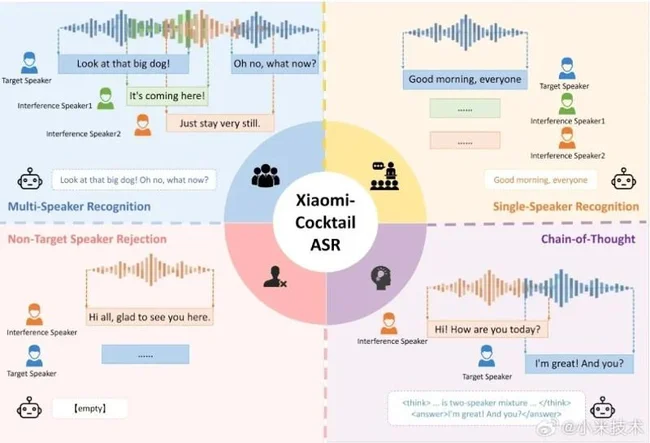
Большинство моделей справляются с расшифровкой речи одного говорящего, но при наложении нескольких голосов текст искажается, предложения сливаются, а реплики путаются между собеседниками.
В отличие от модели OmniVoice, которая генерирует речь, CocktailASR-1 выделяет и расшифровывает уже существующую. Пользователь предоставляет короткий образец голоса нужного человека — модель использует его как эталон для поиска и расшифровки речи именно этого участника записи.
Модель работает и с одиночными голосами, а также умеет избегать ложных срабатываний: если голос-образец отсутствует в записи, CocktailASR-1 вернёт пустой результат вместо ошибочной расшифровки чужой речи.
По данным Xiaomi, в тестах на многоголосных записях модель показала лучшие результаты среди аналогичных решений.
Отдельная функция — режим цепочки рассуждений, позволяющий пользователям видеть логику, на основе которой строилась расшифровка, а не только итоговый текст.
CocktailASR-1 доступна в открытом доступе на GitHub и Hugging Face.